



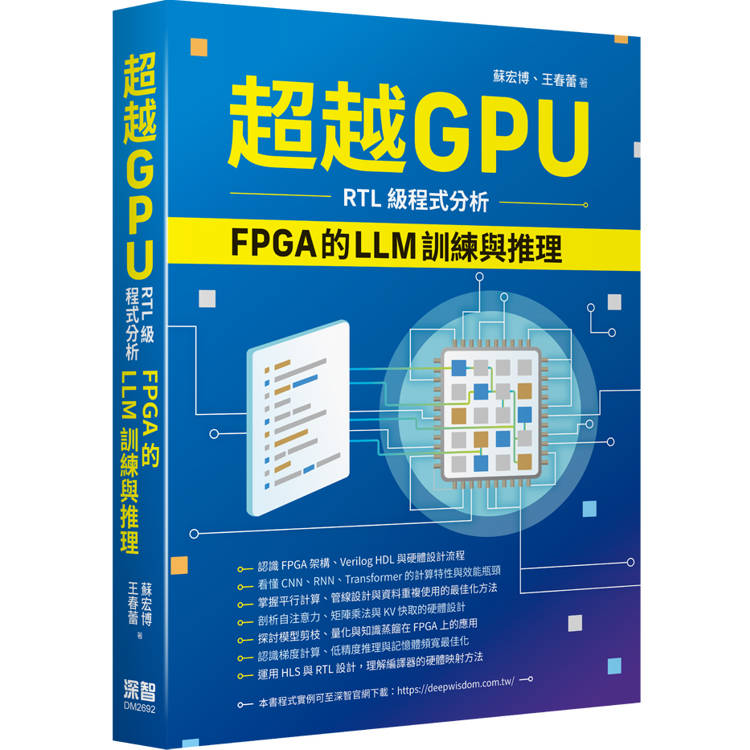
超越 GPU - RTL 級程式分析 FPGA 的 LLM 訓練與推理


活動訊息
金石堂閱讀週年慶第二波

第48次中小學生讀物選介

內容簡介
https://youtu.be/uZkHE3zCrwE
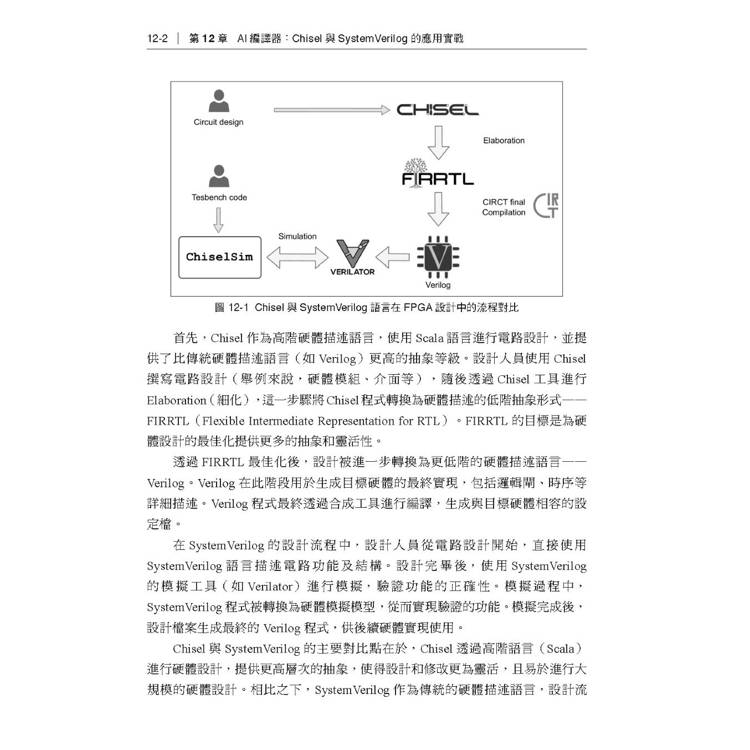
★認識 FPGA 架構、Verilog HDL 與硬體設計流程
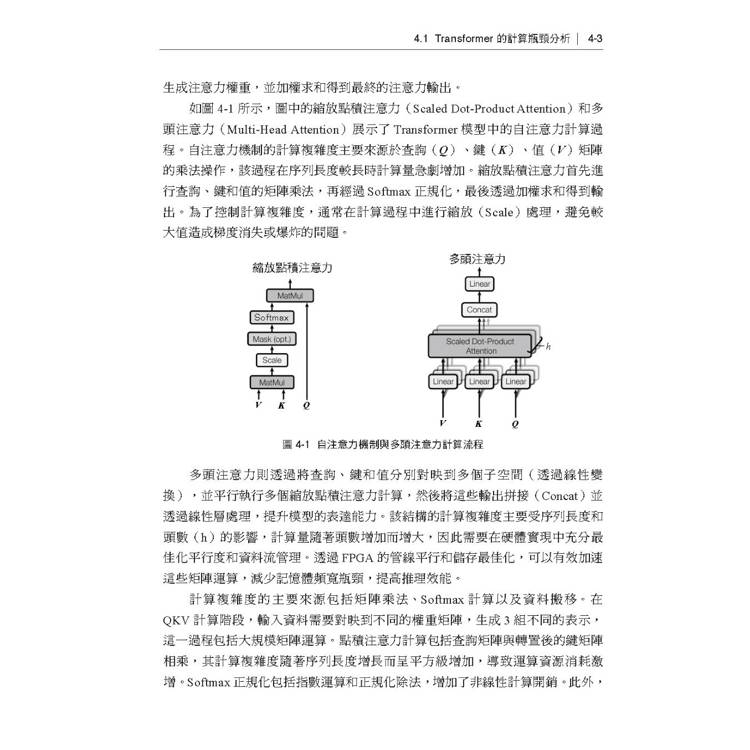
★看懂 CNN、RNN、Transformer 的計算特性與效能瓶頸
★掌握平行計算、管線設計與資料重複使用的最佳化方法
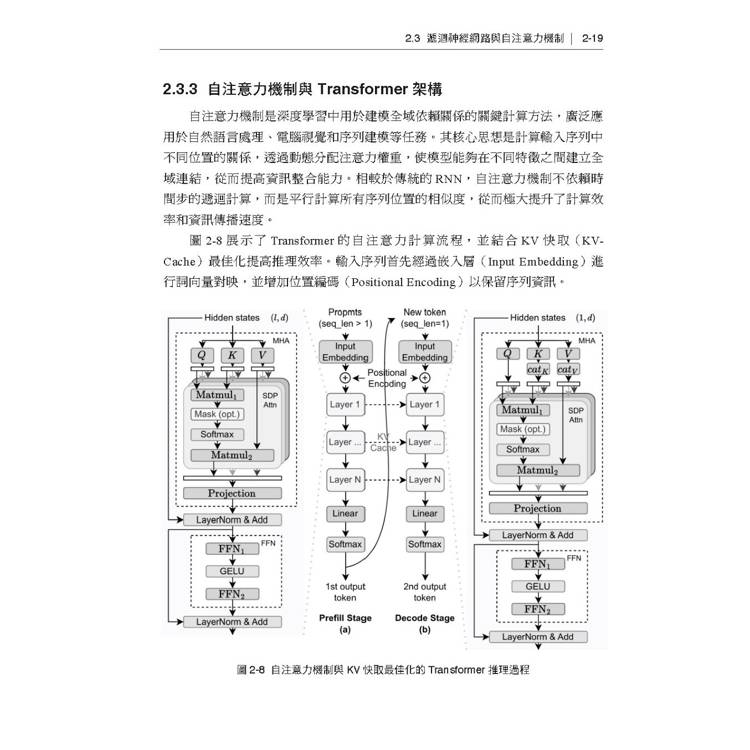
★剖析自注意力、矩陣乘法與 KV 快取的硬體設計
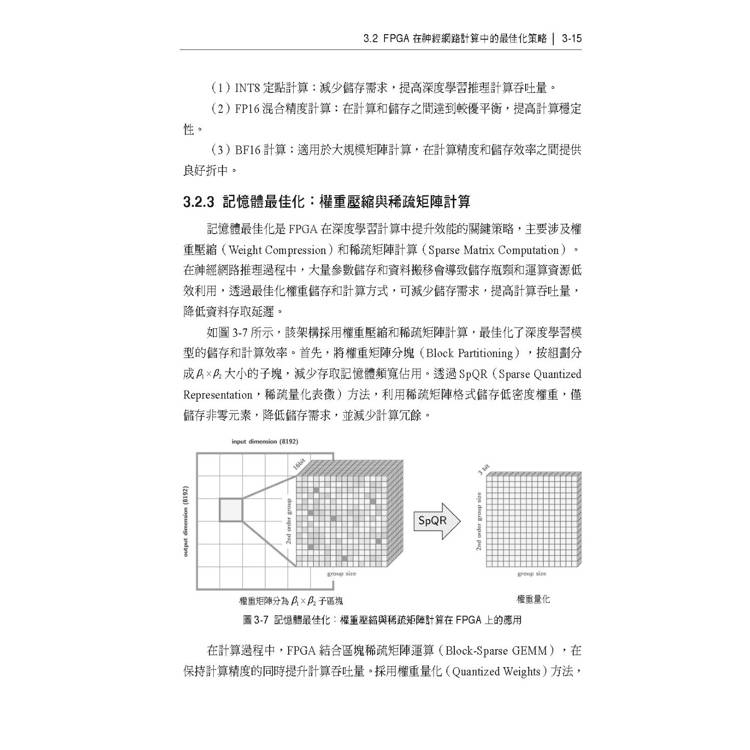
★探討模型剪枝、量化與知識蒸餾在 FPGA 上的應用
★認識梯度計算、低精度推理與記憶體頻寬最佳化
★運用 HLS 與 RTL 設計,理解編譯器的硬體映射方法
大規模深度學習模型的訓練與推理需要處理大量運算,也面臨資料搬移、記憶體頻寬與硬體資源配置等問題。本書介紹 FPGA 架構、Verilog HDL 及深度學習模型的計算特性,並說明平行計算、管線設計、低精度計算與儲存最佳化的方法。
書中進一步討論 Transformer 的硬體加速、模型剪枝與量化,以及計算任務在 FPGA 上的映射。實作章節涵蓋梯度計算、推理加速、動態批次處理與運算資源排程,也介紹 HLS、RTL、OpenCL、Chisel 和 SystemVerilog 的相關應用。
適合 FPGA 設計學習者、FPGA 開發工程師,以及關注深度學習硬體加速的技術人員。
★認識 FPGA 架構、Verilog HDL 與硬體設計流程
★看懂 CNN、RNN、Transformer 的計算特性與效能瓶頸
★掌握平行計算、管線設計與資料重複使用的最佳化方法
★剖析自注意力、矩陣乘法與 KV 快取的硬體設計
★探討模型剪枝、量化與知識蒸餾在 FPGA 上的應用
★認識梯度計算、低精度推理與記憶體頻寬最佳化
★運用 HLS 與 RTL 設計,理解編譯器的硬體映射方法
大規模深度學習模型的訓練與推理需要處理大量運算,也面臨資料搬移、記憶體頻寬與硬體資源配置等問題。本書介紹 FPGA 架構、Verilog HDL 及深度學習模型的計算特性,並說明平行計算、管線設計、低精度計算與儲存最佳化的方法。
書中進一步討論 Transformer 的硬體加速、模型剪枝與量化,以及計算任務在 FPGA 上的映射。實作章節涵蓋梯度計算、推理加速、動態批次處理與運算資源排程,也介紹 HLS、RTL、OpenCL、Chisel 和 SystemVerilog 的相關應用。
適合 FPGA 設計學習者、FPGA 開發工程師,以及關注深度學習硬體加速的技術人員。
目錄
第 1 部分 FPGA 與深度學習基礎
▍第 1 章 FPGA 與Verilog HDL 基礎
1.1 FPGA 的基本架構與計算特性
1.1.1 FPGA 的基本架構:LUT、BRAM、DSP 與互連
1.1.2 FPGA 的平行計算特性及其相較於GPU、CPU 的優勢
1.1.3 FPGA 在深度學習中的主要應用場景
1.2 Verilog HDL 基礎:從硬體描述到合成
1.2.1 Verilog HDL 的基本語法與結構
1.2.2 組合邏輯、時序邏輯與有限狀態機(FSM)設計
1.2.3 FPGA 合成最佳化:面積、速度與功耗的權衡
1.3 FPGA 設計流程與EDA 工具鏈
1.3.1 從RTL 到Bitstream:FPGA 的基本設計流程
1.3.2 Vivado、Quartus 與Synplify:主流EDA 工具解析
1.3.3 FPGA 硬體模擬、偵錯與後端實現
1.4 FPGA 儲存架構與資料最佳化
1.4.1 FPGA 記憶體系統:BRAM、SRAM、DDR 與HBM
1.4.2 資料搬移最佳化:DMA、AXI 匯流排與晶片上快取策略
1.4.3 運算資源最佳化:管線、平行計算與運算子融合
1.5 FPGA、ASIC 與GPU:AI 計算加速方案對比
1.5.1 GPU 加速大模型計算的特點與限制
1.5.2 ASIC 在AI 計算中的優勢
1.5.3 FPGA 的靈活性與計算最佳化能力對比
1.6 本章小結
1.7 思考題
▍第 2 章 從早期神經網路到深度學習
2.1 神經網路的基本概念
2.1.1 感知器與多層感知器
2.1.2 反向傳播演算法與梯度下降
2.1.3 神經網路的收斂性與計算複雜度
2.2 卷積神經網路計算特性
2.2.1 CNN 的基本架構:卷積、池化與全連接層
2.2.2 CNN 在計算中的主要瓶頸:儲存與計算密集型任務
2.2.3 CNN 加速策略:Winograd 變換、FFT 與剪枝
2.3 遞迴神經網路與自注意力機制
2.3.1 RNN、LSTM 與GRU 的結構與計算特點
2.3.2 注意力機制的引入與改進
2.3.3 自注意力機制與Transformer 架構
2.4 Transformer 架構的計算特性
2.4.1 Transformer 的基本計算流程與平行計算特點
2.4.2 多頭注意力與矩陣運算最佳化
2.4.3 位置編碼計算
2.5 深度學習計算的FPGA 最佳化想法
2.5.1 計算圖的硬體實現
2.5.2 資料重複使用、頻寬最佳化與低位元量化計算
2.6 本章小結
2.7 思考題
▍第 3 章 深度學習計算加速的基本想法
3.1 硬體加速基礎:平行計算與管線最佳化
3.1.1 資料流架構與計算最佳化
3.1.2 計算任務的平行化與時序最佳化
3.1.3 指令級平行與資料級平行在FPGA 中的實現
3.2 FPGA 在神經網路計算中的最佳化策略
3.2.1 計算任務拆分:時間重複使用與空間重複使用
3.2.2 低精度計算(INT8、FP16、BF16)在FPGA 上的實現
3.2.3 記憶體最佳化:權重壓縮與稀疏矩陣計算
3.3 模型剪枝與量化技術
3.3.1 模型剪枝技術與硬體對映
3.3.2 量化感知訓練與訓練後量化
3.4 大規模計算的儲存最佳化
3.4.1 晶片上快取與資料重複使用策略
3.4.2 DDR、HBM 頻寬最佳化:預先存取與存取記憶體排程
3.4.3 計算-儲存協作最佳化策略
3.4.4 深度學習編譯器與FPGA 加速
3.4.5 TVM、XLA 與OneAPI:神經網路編譯最佳化
3.4.6 HLS 與RTL 最佳化的對比
3.5 本章小結
3.6 思考題
第 2 部分 FPGA 在大模型加速中的應用
▍第 4 章 Transformer 模型的硬體加速
4.1 Transformer 的計算瓶頸分析
4.1.1 自注意力機制的計算複雜度
4.1.2 前饋神經網路與矩陣乘法加速
4.1.3 KV 快取與儲存最佳化
4.2 FPGA 在Transformer 計算中的應用
4.2.1 矩陣乘法最佳化:Tile-Based Computation
4.2.2 自注意力計算的硬體最佳化
4.2.3 FPGA 在低位元Transformer 中的應用
4.3 大模型推理的硬體最佳化策略
4.3.1 動態批次處理與推理加速
4.3.2 低精度推理(BF16、INT8)在FPGA 上的實現
4.3.3 計算-通訊協作最佳化——管線平行
4.4 本章小結
4.5 思考題
▍第 5 章 FPGA 在大模型訓練中的應用
5.1 訓練任務的計算特性
5.1.1 訓練與推理:計算模式的區別
5.1.2 計算密集型與儲存密集型任務分析
5.2 反向傳播的硬體最佳化
5.2.1 誤差反向傳播計算的矩陣運算特性
5.2.2 梯度計算與權重更新的最佳化策略
5.2.3 使用FPGA 高效實現自動微分
5.3 FPGA 在大規模訓練中的優勢
5.3.1 低延遲計算的硬體實現
5.3.2 晶片上平行管線訓練最佳化
5.3.3 資料搬移與存取記憶體最佳化
5.3.4 訓練資料流的批次處理與排程策略
5.3.5 計算-儲存比最佳化:減少存取記憶體瓶頸
5.3.6 FPGA 與GPU 協作訓練的應用
5.4 本章小結
5.5 思考題
▍第 6 章 FPGA 在異質計算架構中的角色
6.1 FPGA、CPU 與GPU 協作計算架構
6.1.1 異質計算的基本概念與挑戰
6.1.2 FPGA 作為輔助處理器的計算任務分配
6.1.3 低延遲資料交換機制
6.2 高速互連技術與資料傳輸最佳化
6.2.1 PCIe、NVLink 與CCIX 的對比分析
6.2.2 FPGA 的資料傳輸最佳化方案
6.3 本章小結
6.4 思考題
▍第 7 章 模型壓縮與量化技術
7.1 模型剪枝技術
7.1.1 結構化剪枝與非結構化剪枝
7.1.2 剪枝演算法與硬體對映最佳化
7.1.3 剪枝在FPGA 計算中的相容性
7.2 低位元量化在FPGA 上的實現
7.2.1 INT8、FP16、BF16 的硬體實現區別
7.2.2 量化感知訓練與傳統量化方法
7.2.3 量化計算對FPGA 資源使用的影響
7.3 知識蒸餾加速推理
7.3.1 知識蒸餾的基本原理
7.3.2 輕量級子模型的訓練與部署
7.3.3 知識蒸餾在硬體加速中的應用
7.4 模型壓縮在FPGA 推理中的應用
7.4.1 大規模Transformer 模型的儲存最佳化
7.4.2 稀疏計算在FPGA 上的實現方案
7.4.3 FPGA 如何支援動態精度計算
7.5 大模型推理中的頻寬最佳化
7.5.1 儲存與計算的權衡
7.5.2 記憶體管理最佳化策略
7.5.3 FPGA 的晶片上儲存架構最佳化
7.6 本章小結
7.7 思考題
▍第 8 章 面向FPGA 的深度學習編譯器
8.1 深度學習編譯器概述
8.1.1 TVM、XLA、TensorRT 的對比分析
8.1.2 計算圖最佳化與硬體後端對映
8.1.3 編譯器在FPGA 計算最佳化中的作用
8.2 高層次合成與RTL 最佳化
8.2.1 HLS 程式設計與RTL 設計:適用場景分析
8.2.2 HLS 自動最佳化策略
8.2.3 RTL 的手工最佳化方法
8.3 FPGA 編譯最佳化的關鍵技術
8.3.1 硬體計算圖
8.3.2 計算任務的自動劃分與對映
8.4 面向FPGA 的端對端編譯框架
8.4.1 TVM 的FPGA 後端最佳化
8.4.2 MLIR 在FPGA 計算中的應用
8.4.3 自動化硬體對映與效能調校
8.5 本章小結
8.6 思考題
第 3 部分 FPGA 加速實戰與最佳化策略
▍第 9 章 FPGA 加速大模型訓練實戰應用
9.1 訓練過程的計算挑戰
9.1.1 訓練中的計算密集型任務與儲存瓶頸
9.1.2 反向傳播的計算特性與最佳化想法
9.1.3 計算圖最佳化對硬體加速的影響
9.2 FPGA 在大規模梯度計算中的應用
9.2.1 矩陣乘法最佳化:基於切區塊的計算
9.2.2 低精度計算
9.2.3 動態計算最佳化
9.3 FPGA 的晶片上訓練架構最佳化
9.3.1 資料重複使用與管線最佳化策略
9.3.2 計算-儲存協作最佳化:頻寬與延遲的平衡
9.3.3 訓練任務的硬體分散式排程
9.4 FPGA 在分散式訓練中的應用
9.4.1 FPGA-CPU-GPU 協作計算訓練架構
9.4.2 FPGA 支援的混合平行訓練策略
9.4.3 高速互連技術在訓練中的最佳化
9.5 本章小結
9.6 思考題
▍第 10 章 FPGA 加速大模型推理實戰應用
10.1 推理任務的特點與硬體加速需求
10.1.1 推理過程中的計算與延遲要求
10.1.2 記憶體和儲存頻寬的最佳化問題
10.1.3 在FPGA 上的推理架構選擇
10.1.4 使用HLS 完成模型推理與訓練的差異化設計
10.2 採用HLS 實現深度學習推理加速
10.2.1 Vivado HLS 深度解析
10.2.2 基於HLS 的張量運算加速器設計
10.2.3 基於HLS 的推理過程中的計算精度與最佳化
10.2.4 FPGA 資源使用率與推理效能的關係
10.3 低精度計算與FPGA 推理最佳化
10.3.1 基於SystemVerilog 的INT8、FP16 精度的硬體實現
10.3.2 低位元量化在FPGA 推理中的應用
10.3.3 資料壓縮與記憶體頻寬最佳化
10.3.4 量化與硬體資源對映策略
10.4 推理過程中的動態批次處理最佳化
10.4.1 動態批次處理的FPGA 實現策略
10.4.2 管線化設計與運算資源最佳化
10.4.3 Zynq 異質計算平臺中的批次處理最佳化
10.4.4 Verilog 中的批次處理排程與效能提升
10.5 資料通訊與儲存最佳化:FPGA 加速推理
10.5.1 資料傳輸與記憶體存取最佳化
10.5.2 FPGA 中的晶片上快取與資料重複使用
10.5.3 高效的儲存對映與平行計算
10.6 FPGA 推理加速與自動化編譯框架的結合
10.6.1 TVM 與FPGA 推理加速的結合
10.6.2 編譯器最佳化與硬體資源對映
10.6.3 硬體加速與雲端推理的協作工作
10.7 本章小結
10.8 思考題
▍第 11 章 超純量架構與雙通路最佳化:OpenCL 與HLS 的應用實戰
11.1 OpenCL 與FPGA 加速框架
11.1.1 OpenCL 在FPGA 中的工作原理
11.1.2 FPGA 加速框架的硬體抽象層
11.1.3 OpenCL 編譯流程與最佳化策略
11.2 HLS 在大模型訓練中的應用
11.2.1 HLS 程式設計模型與FPGA 設計流程
11.2.2 HLS 最佳化策略與效能提升
11.2.3 HLS 與RTL 設計的協作工作
11.3 矩陣運算與梯度計算加速
11.3.1 矩陣乘法的HLS 與OpenCL 實現
11.3.2 利用OpenCL 完成梯度計算的管線設計與最佳化
11.3.3 資料存取與記憶體頻寬最佳化
11.4 控制通路與資料通路最佳化
11.4.1 控制通路設計與時序最佳化
11.4.2 資料通路的平行化與管線
11.4.3 控制通路與資料通路的協作最佳化
11.5 超純量架構與超長指令字在FPGA 中的實現
11.5.1 超純量架構的設計與應用
11.5.2 超長指令字在FPGA 中的實現方法
11.5.3 高效的計算任務排程與平行執行
11.6 本章小結
11.7 思考題
▍第 12 章 AI 編譯器:Chisel 與SystemVerilog 的應用實戰
12.1 Chisel 與SystemVerilog 在推理加速中的應用
12.1.1 Chisel 與SystemVerilog 語言對比
12.1.2 推理加速中的硬體模組設計與對映
12.1.3 基於Chisel 與SystemVerilog 的硬體模組最佳化
12.2 AI 編譯器與FPGA 推理加速
12.2.1 AI 編譯器的工作原理與FPGA 適配
12.2.2 推理任務的硬體對映與最佳化
12.2.3 編譯器最佳化策略與FPGA 效能提升
12.3 高效資料流與儲存最佳化
12.3.1 FPGA 中的資料流設計與最佳化
12.3.2 儲存架構最佳化與記憶體頻寬管理
12.4 FPGA 推理加速中的運算資源排程與分配
12.4.1 運算資源的動態排程與任務劃分
12.4.2 硬體資源排程演算法與平行推理
12.4.3 FPGA 資源配置與多工推理的協作最佳化
12.5 本章小結
12.6 思考題
▍第 1 章 FPGA 與Verilog HDL 基礎
1.1 FPGA 的基本架構與計算特性
1.1.1 FPGA 的基本架構:LUT、BRAM、DSP 與互連
1.1.2 FPGA 的平行計算特性及其相較於GPU、CPU 的優勢
1.1.3 FPGA 在深度學習中的主要應用場景
1.2 Verilog HDL 基礎:從硬體描述到合成
1.2.1 Verilog HDL 的基本語法與結構
1.2.2 組合邏輯、時序邏輯與有限狀態機(FSM)設計
1.2.3 FPGA 合成最佳化:面積、速度與功耗的權衡
1.3 FPGA 設計流程與EDA 工具鏈
1.3.1 從RTL 到Bitstream:FPGA 的基本設計流程
1.3.2 Vivado、Quartus 與Synplify:主流EDA 工具解析
1.3.3 FPGA 硬體模擬、偵錯與後端實現
1.4 FPGA 儲存架構與資料最佳化
1.4.1 FPGA 記憶體系統:BRAM、SRAM、DDR 與HBM
1.4.2 資料搬移最佳化:DMA、AXI 匯流排與晶片上快取策略
1.4.3 運算資源最佳化:管線、平行計算與運算子融合
1.5 FPGA、ASIC 與GPU:AI 計算加速方案對比
1.5.1 GPU 加速大模型計算的特點與限制
1.5.2 ASIC 在AI 計算中的優勢
1.5.3 FPGA 的靈活性與計算最佳化能力對比
1.6 本章小結
1.7 思考題
▍第 2 章 從早期神經網路到深度學習
2.1 神經網路的基本概念
2.1.1 感知器與多層感知器
2.1.2 反向傳播演算法與梯度下降
2.1.3 神經網路的收斂性與計算複雜度
2.2 卷積神經網路計算特性
2.2.1 CNN 的基本架構:卷積、池化與全連接層
2.2.2 CNN 在計算中的主要瓶頸:儲存與計算密集型任務
2.2.3 CNN 加速策略:Winograd 變換、FFT 與剪枝
2.3 遞迴神經網路與自注意力機制
2.3.1 RNN、LSTM 與GRU 的結構與計算特點
2.3.2 注意力機制的引入與改進
2.3.3 自注意力機制與Transformer 架構
2.4 Transformer 架構的計算特性
2.4.1 Transformer 的基本計算流程與平行計算特點
2.4.2 多頭注意力與矩陣運算最佳化
2.4.3 位置編碼計算
2.5 深度學習計算的FPGA 最佳化想法
2.5.1 計算圖的硬體實現
2.5.2 資料重複使用、頻寬最佳化與低位元量化計算
2.6 本章小結
2.7 思考題
▍第 3 章 深度學習計算加速的基本想法
3.1 硬體加速基礎:平行計算與管線最佳化
3.1.1 資料流架構與計算最佳化
3.1.2 計算任務的平行化與時序最佳化
3.1.3 指令級平行與資料級平行在FPGA 中的實現
3.2 FPGA 在神經網路計算中的最佳化策略
3.2.1 計算任務拆分:時間重複使用與空間重複使用
3.2.2 低精度計算(INT8、FP16、BF16)在FPGA 上的實現
3.2.3 記憶體最佳化:權重壓縮與稀疏矩陣計算
3.3 模型剪枝與量化技術
3.3.1 模型剪枝技術與硬體對映
3.3.2 量化感知訓練與訓練後量化
3.4 大規模計算的儲存最佳化
3.4.1 晶片上快取與資料重複使用策略
3.4.2 DDR、HBM 頻寬最佳化:預先存取與存取記憶體排程
3.4.3 計算-儲存協作最佳化策略
3.4.4 深度學習編譯器與FPGA 加速
3.4.5 TVM、XLA 與OneAPI:神經網路編譯最佳化
3.4.6 HLS 與RTL 最佳化的對比
3.5 本章小結
3.6 思考題
第 2 部分 FPGA 在大模型加速中的應用
▍第 4 章 Transformer 模型的硬體加速
4.1 Transformer 的計算瓶頸分析
4.1.1 自注意力機制的計算複雜度
4.1.2 前饋神經網路與矩陣乘法加速
4.1.3 KV 快取與儲存最佳化
4.2 FPGA 在Transformer 計算中的應用
4.2.1 矩陣乘法最佳化:Tile-Based Computation
4.2.2 自注意力計算的硬體最佳化
4.2.3 FPGA 在低位元Transformer 中的應用
4.3 大模型推理的硬體最佳化策略
4.3.1 動態批次處理與推理加速
4.3.2 低精度推理(BF16、INT8)在FPGA 上的實現
4.3.3 計算-通訊協作最佳化——管線平行
4.4 本章小結
4.5 思考題
▍第 5 章 FPGA 在大模型訓練中的應用
5.1 訓練任務的計算特性
5.1.1 訓練與推理:計算模式的區別
5.1.2 計算密集型與儲存密集型任務分析
5.2 反向傳播的硬體最佳化
5.2.1 誤差反向傳播計算的矩陣運算特性
5.2.2 梯度計算與權重更新的最佳化策略
5.2.3 使用FPGA 高效實現自動微分
5.3 FPGA 在大規模訓練中的優勢
5.3.1 低延遲計算的硬體實現
5.3.2 晶片上平行管線訓練最佳化
5.3.3 資料搬移與存取記憶體最佳化
5.3.4 訓練資料流的批次處理與排程策略
5.3.5 計算-儲存比最佳化:減少存取記憶體瓶頸
5.3.6 FPGA 與GPU 協作訓練的應用
5.4 本章小結
5.5 思考題
▍第 6 章 FPGA 在異質計算架構中的角色
6.1 FPGA、CPU 與GPU 協作計算架構
6.1.1 異質計算的基本概念與挑戰
6.1.2 FPGA 作為輔助處理器的計算任務分配
6.1.3 低延遲資料交換機制
6.2 高速互連技術與資料傳輸最佳化
6.2.1 PCIe、NVLink 與CCIX 的對比分析
6.2.2 FPGA 的資料傳輸最佳化方案
6.3 本章小結
6.4 思考題
▍第 7 章 模型壓縮與量化技術
7.1 模型剪枝技術
7.1.1 結構化剪枝與非結構化剪枝
7.1.2 剪枝演算法與硬體對映最佳化
7.1.3 剪枝在FPGA 計算中的相容性
7.2 低位元量化在FPGA 上的實現
7.2.1 INT8、FP16、BF16 的硬體實現區別
7.2.2 量化感知訓練與傳統量化方法
7.2.3 量化計算對FPGA 資源使用的影響
7.3 知識蒸餾加速推理
7.3.1 知識蒸餾的基本原理
7.3.2 輕量級子模型的訓練與部署
7.3.3 知識蒸餾在硬體加速中的應用
7.4 模型壓縮在FPGA 推理中的應用
7.4.1 大規模Transformer 模型的儲存最佳化
7.4.2 稀疏計算在FPGA 上的實現方案
7.4.3 FPGA 如何支援動態精度計算
7.5 大模型推理中的頻寬最佳化
7.5.1 儲存與計算的權衡
7.5.2 記憶體管理最佳化策略
7.5.3 FPGA 的晶片上儲存架構最佳化
7.6 本章小結
7.7 思考題
▍第 8 章 面向FPGA 的深度學習編譯器
8.1 深度學習編譯器概述
8.1.1 TVM、XLA、TensorRT 的對比分析
8.1.2 計算圖最佳化與硬體後端對映
8.1.3 編譯器在FPGA 計算最佳化中的作用
8.2 高層次合成與RTL 最佳化
8.2.1 HLS 程式設計與RTL 設計:適用場景分析
8.2.2 HLS 自動最佳化策略
8.2.3 RTL 的手工最佳化方法
8.3 FPGA 編譯最佳化的關鍵技術
8.3.1 硬體計算圖
8.3.2 計算任務的自動劃分與對映
8.4 面向FPGA 的端對端編譯框架
8.4.1 TVM 的FPGA 後端最佳化
8.4.2 MLIR 在FPGA 計算中的應用
8.4.3 自動化硬體對映與效能調校
8.5 本章小結
8.6 思考題
第 3 部分 FPGA 加速實戰與最佳化策略
▍第 9 章 FPGA 加速大模型訓練實戰應用
9.1 訓練過程的計算挑戰
9.1.1 訓練中的計算密集型任務與儲存瓶頸
9.1.2 反向傳播的計算特性與最佳化想法
9.1.3 計算圖最佳化對硬體加速的影響
9.2 FPGA 在大規模梯度計算中的應用
9.2.1 矩陣乘法最佳化:基於切區塊的計算
9.2.2 低精度計算
9.2.3 動態計算最佳化
9.3 FPGA 的晶片上訓練架構最佳化
9.3.1 資料重複使用與管線最佳化策略
9.3.2 計算-儲存協作最佳化:頻寬與延遲的平衡
9.3.3 訓練任務的硬體分散式排程
9.4 FPGA 在分散式訓練中的應用
9.4.1 FPGA-CPU-GPU 協作計算訓練架構
9.4.2 FPGA 支援的混合平行訓練策略
9.4.3 高速互連技術在訓練中的最佳化
9.5 本章小結
9.6 思考題
▍第 10 章 FPGA 加速大模型推理實戰應用
10.1 推理任務的特點與硬體加速需求
10.1.1 推理過程中的計算與延遲要求
10.1.2 記憶體和儲存頻寬的最佳化問題
10.1.3 在FPGA 上的推理架構選擇
10.1.4 使用HLS 完成模型推理與訓練的差異化設計
10.2 採用HLS 實現深度學習推理加速
10.2.1 Vivado HLS 深度解析
10.2.2 基於HLS 的張量運算加速器設計
10.2.3 基於HLS 的推理過程中的計算精度與最佳化
10.2.4 FPGA 資源使用率與推理效能的關係
10.3 低精度計算與FPGA 推理最佳化
10.3.1 基於SystemVerilog 的INT8、FP16 精度的硬體實現
10.3.2 低位元量化在FPGA 推理中的應用
10.3.3 資料壓縮與記憶體頻寬最佳化
10.3.4 量化與硬體資源對映策略
10.4 推理過程中的動態批次處理最佳化
10.4.1 動態批次處理的FPGA 實現策略
10.4.2 管線化設計與運算資源最佳化
10.4.3 Zynq 異質計算平臺中的批次處理最佳化
10.4.4 Verilog 中的批次處理排程與效能提升
10.5 資料通訊與儲存最佳化:FPGA 加速推理
10.5.1 資料傳輸與記憶體存取最佳化
10.5.2 FPGA 中的晶片上快取與資料重複使用
10.5.3 高效的儲存對映與平行計算
10.6 FPGA 推理加速與自動化編譯框架的結合
10.6.1 TVM 與FPGA 推理加速的結合
10.6.2 編譯器最佳化與硬體資源對映
10.6.3 硬體加速與雲端推理的協作工作
10.7 本章小結
10.8 思考題
▍第 11 章 超純量架構與雙通路最佳化:OpenCL 與HLS 的應用實戰
11.1 OpenCL 與FPGA 加速框架
11.1.1 OpenCL 在FPGA 中的工作原理
11.1.2 FPGA 加速框架的硬體抽象層
11.1.3 OpenCL 編譯流程與最佳化策略
11.2 HLS 在大模型訓練中的應用
11.2.1 HLS 程式設計模型與FPGA 設計流程
11.2.2 HLS 最佳化策略與效能提升
11.2.3 HLS 與RTL 設計的協作工作
11.3 矩陣運算與梯度計算加速
11.3.1 矩陣乘法的HLS 與OpenCL 實現
11.3.2 利用OpenCL 完成梯度計算的管線設計與最佳化
11.3.3 資料存取與記憶體頻寬最佳化
11.4 控制通路與資料通路最佳化
11.4.1 控制通路設計與時序最佳化
11.4.2 資料通路的平行化與管線
11.4.3 控制通路與資料通路的協作最佳化
11.5 超純量架構與超長指令字在FPGA 中的實現
11.5.1 超純量架構的設計與應用
11.5.2 超長指令字在FPGA 中的實現方法
11.5.3 高效的計算任務排程與平行執行
11.6 本章小結
11.7 思考題
▍第 12 章 AI 編譯器:Chisel 與SystemVerilog 的應用實戰
12.1 Chisel 與SystemVerilog 在推理加速中的應用
12.1.1 Chisel 與SystemVerilog 語言對比
12.1.2 推理加速中的硬體模組設計與對映
12.1.3 基於Chisel 與SystemVerilog 的硬體模組最佳化
12.2 AI 編譯器與FPGA 推理加速
12.2.1 AI 編譯器的工作原理與FPGA 適配
12.2.2 推理任務的硬體對映與最佳化
12.2.3 編譯器最佳化策略與FPGA 效能提升
12.3 高效資料流與儲存最佳化
12.3.1 FPGA 中的資料流設計與最佳化
12.3.2 儲存架構最佳化與記憶體頻寬管理
12.4 FPGA 推理加速中的運算資源排程與分配
12.4.1 運算資源的動態排程與任務劃分
12.4.2 硬體資源排程演算法與平行推理
12.4.3 FPGA 資源配置與多工推理的協作最佳化
12.5 本章小結
12.6 思考題
序/導讀
前言
隨著深度學習的迅猛發展,大規模神經網路已廣泛應用於自然語言處理、電腦視覺和語音辨識等領域,並逐步滲透到各行各業。大模型對運算資源的需求不斷攀升,特別是在訓練和推理階段,計算任務的複雜度和規模已遠超傳統處理器的處理能力。
為應對這一挑戰,硬體加速技術應運而生,尤其是FPGA(Field Programmable Gate Array,現場可程式化閘陣列),憑藉其高度的平行計算能力和設計靈活性,成為深度學習加速中的重要解決方案。
本書從FPGA 硬體加速的角度出發,系統探討如何借助FPGA 加速大規模深度學習模型的訓練與推理過程,並透過具體的硬體設計和最佳化案例,全面展示FPGA 在深度學習計算中的巨大潛力。
本書分為3 部分,循序漸進地引導讀者從理論基礎邁向實戰應用,全面掌握 FPGA 加速深度學習的核心技術。
第1 部分:FPGA 與深度學習基礎。本部分旨在幫助讀者奠定堅實的理論與技術基礎,內容包括FPGA 硬體架構、設計流程及深度學習加速的基本方法。
• 第 1 章:介紹 FPGA 的基本架構和計算特性,闡述 FPGA 在深度學習中的應用場景,並講解Verilog HDL 的基礎語法及其在FPGA 硬體設計中的實際應用。
• 第 2 章:重點講解神經網路的基本概念,從感知器發展到深度學習,分析常見模型(如CNN、RNN、Transformer)的計算特性與效能瓶頸。
• 第 3 章:聚焦 FPGA 在神經網路加速中的最佳化想法,介紹如何透過平行計算、管線最佳化、低精度計算等技術提升FPGA 的計算效能,並探討其在儲存最佳化和計算圖硬體實現方面的應用。
第2 部分:FPGA 在大模型加速中的應用。本部分深入探討FPGA 在Transformer 和卷積神經網路(CNN)等大模型中的應用,聚焦於加速策略和效能最佳化實踐。
•第 4 章:剖析 Transformer 模型中的計算瓶頸,特別是自注意力機制和矩陣乘法方面的加速方法。
• 第 5 章:詳細講解如何透過低精度計算、動態批次處理、資料壓縮和記憶體頻寬最佳化等關鍵技術來加速大模型的推理過程。
• 第 6 章:介紹如何在 FPGA 上實現基於模型剪枝與量化的加速最佳化,探討如何透過異質計算架構(FPGA、GPU 與CPU 協作工作)來提升計算效能。
• 第 7 章:進一步探討模型壓縮與量化技術(如模型剪枝、低位元量化和知識蒸餾等)在FPGA 平臺上的應用。
• 第8章:講解面向FPGA的深度學習編譯器開發,涵蓋高層次合成(HLS)與RTL 最佳化的關鍵技術。
第3 部分:FPGA 加速實戰與最佳化策略。本部分著重討論FPGA 在深度學習訓練和推理中的實戰應用與最佳化策略。
• 第 9 章:深入探討如何透過 FPGA 加速大模型訓練,重點分析計算任務的劃分、最佳化與資源配置,闡明如何利用FPGA 的高平行性與低延遲特性,實現大模型訓練過程中的高效計算。
• 第 10 章:介紹如何利用 Verilog 設計低精度計算加速器,並進一步探討資源排程、動態批次處理最佳化與資料通訊最佳化等方法,提升FPGA推理加速效能。
• 第 11 章:深入分析 OpenCL 與 HLS 在大模型訓練中的應用,重點闡述如何透過HLS 與RTL 設計的協作工作來最佳化FPGA 硬體模組。
• 第 12 章:集中討論運算資源排程演算法、多工推理的協作最佳化等方面的技術,提供在多工推理場景下高效分配運算資源的實戰經驗。
本書融合了FPGA 硬體設計、深度學習加速以及編譯最佳化等多個前沿方向,致力於為讀者建構一個系統的技術框架,幫助讀者從底層硬體設計到高層最佳化實現,全面掌握FPGA 在大規模深度學習推理中的應用方法與關鍵技術。
本書適合學習FPGA 設計的學生、從事FPGA 開發的專業工程師,以及對高效能計算感興趣的技術人員。無論讀者是希望深入了解FPGA 的硬體設計原理,還是探索如何將深度學習演算法高效部署到FPGA 平臺,本書都能提供系統性的理論指導和豐富的實戰經驗。
期望讀者透過本書的學習,不僅能掌握FPGA 加速深度學習的核心技術,還能將所學應用於實際專案中,解決大模型訓練和推理中的計算瓶頸問題。同時,也希望本書能夠激發讀者在硬體加速與深度學習交叉領域的創新思維,推動更多高效、低功耗的AI 計算解決方案的實踐與發展。
隨著深度學習的迅猛發展,大規模神經網路已廣泛應用於自然語言處理、電腦視覺和語音辨識等領域,並逐步滲透到各行各業。大模型對運算資源的需求不斷攀升,特別是在訓練和推理階段,計算任務的複雜度和規模已遠超傳統處理器的處理能力。
為應對這一挑戰,硬體加速技術應運而生,尤其是FPGA(Field Programmable Gate Array,現場可程式化閘陣列),憑藉其高度的平行計算能力和設計靈活性,成為深度學習加速中的重要解決方案。
本書從FPGA 硬體加速的角度出發,系統探討如何借助FPGA 加速大規模深度學習模型的訓練與推理過程,並透過具體的硬體設計和最佳化案例,全面展示FPGA 在深度學習計算中的巨大潛力。
本書分為3 部分,循序漸進地引導讀者從理論基礎邁向實戰應用,全面掌握 FPGA 加速深度學習的核心技術。
第1 部分:FPGA 與深度學習基礎。本部分旨在幫助讀者奠定堅實的理論與技術基礎,內容包括FPGA 硬體架構、設計流程及深度學習加速的基本方法。
• 第 1 章:介紹 FPGA 的基本架構和計算特性,闡述 FPGA 在深度學習中的應用場景,並講解Verilog HDL 的基礎語法及其在FPGA 硬體設計中的實際應用。
• 第 2 章:重點講解神經網路的基本概念,從感知器發展到深度學習,分析常見模型(如CNN、RNN、Transformer)的計算特性與效能瓶頸。
• 第 3 章:聚焦 FPGA 在神經網路加速中的最佳化想法,介紹如何透過平行計算、管線最佳化、低精度計算等技術提升FPGA 的計算效能,並探討其在儲存最佳化和計算圖硬體實現方面的應用。
第2 部分:FPGA 在大模型加速中的應用。本部分深入探討FPGA 在Transformer 和卷積神經網路(CNN)等大模型中的應用,聚焦於加速策略和效能最佳化實踐。
•第 4 章:剖析 Transformer 模型中的計算瓶頸,特別是自注意力機制和矩陣乘法方面的加速方法。
• 第 5 章:詳細講解如何透過低精度計算、動態批次處理、資料壓縮和記憶體頻寬最佳化等關鍵技術來加速大模型的推理過程。
• 第 6 章:介紹如何在 FPGA 上實現基於模型剪枝與量化的加速最佳化,探討如何透過異質計算架構(FPGA、GPU 與CPU 協作工作)來提升計算效能。
• 第 7 章:進一步探討模型壓縮與量化技術(如模型剪枝、低位元量化和知識蒸餾等)在FPGA 平臺上的應用。
• 第8章:講解面向FPGA的深度學習編譯器開發,涵蓋高層次合成(HLS)與RTL 最佳化的關鍵技術。
第3 部分:FPGA 加速實戰與最佳化策略。本部分著重討論FPGA 在深度學習訓練和推理中的實戰應用與最佳化策略。
• 第 9 章:深入探討如何透過 FPGA 加速大模型訓練,重點分析計算任務的劃分、最佳化與資源配置,闡明如何利用FPGA 的高平行性與低延遲特性,實現大模型訓練過程中的高效計算。
• 第 10 章:介紹如何利用 Verilog 設計低精度計算加速器,並進一步探討資源排程、動態批次處理最佳化與資料通訊最佳化等方法,提升FPGA推理加速效能。
• 第 11 章:深入分析 OpenCL 與 HLS 在大模型訓練中的應用,重點闡述如何透過HLS 與RTL 設計的協作工作來最佳化FPGA 硬體模組。
• 第 12 章:集中討論運算資源排程演算法、多工推理的協作最佳化等方面的技術,提供在多工推理場景下高效分配運算資源的實戰經驗。
本書融合了FPGA 硬體設計、深度學習加速以及編譯最佳化等多個前沿方向,致力於為讀者建構一個系統的技術框架,幫助讀者從底層硬體設計到高層最佳化實現,全面掌握FPGA 在大規模深度學習推理中的應用方法與關鍵技術。
本書適合學習FPGA 設計的學生、從事FPGA 開發的專業工程師,以及對高效能計算感興趣的技術人員。無論讀者是希望深入了解FPGA 的硬體設計原理,還是探索如何將深度學習演算法高效部署到FPGA 平臺,本書都能提供系統性的理論指導和豐富的實戰經驗。
期望讀者透過本書的學習,不僅能掌握FPGA 加速深度學習的核心技術,還能將所學應用於實際專案中,解決大模型訓練和推理中的計算瓶頸問題。同時,也希望本書能夠激發讀者在硬體加速與深度學習交叉領域的創新思維,推動更多高效、低功耗的AI 計算解決方案的實踐與發展。
贈品
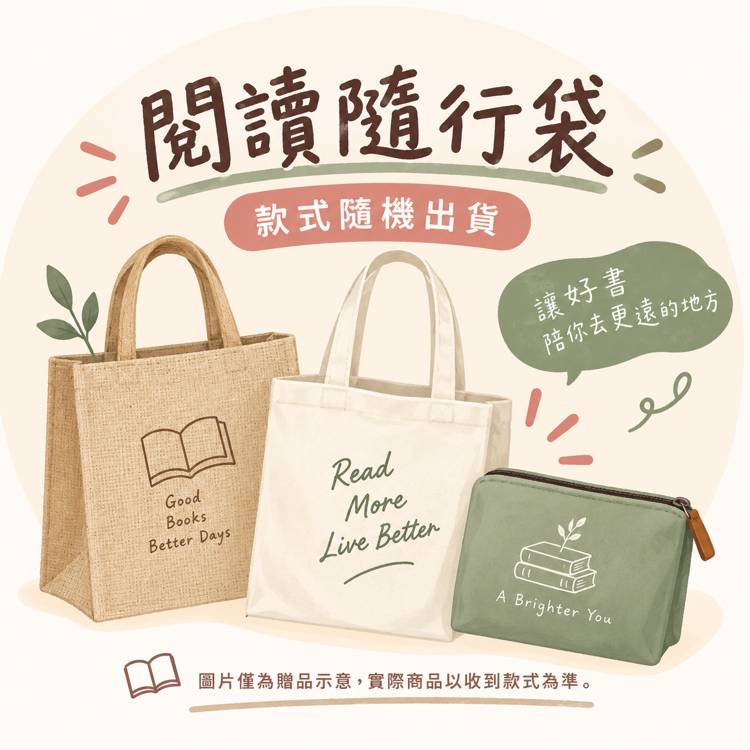
指定商品滿$888即贈 閱讀隨行袋(款式隨機)
凡全站商品單筆訂單滿888元,即送「閱讀隨行袋」1個,款式隨機出貨。(數量有限,送完為止)
※ 海外訂單恕不提供贈品。
贈品已送完
指定商品滿$3500即贈 小編私藏禮
凡週年慶期間指定商品滿3500即贈小編私藏禮一份
※ 海外訂單恕不提供贈品。
贈品已送完
配送方式
-
台灣
- 國內宅配:本島、離島
-
到店取貨:
 不限金額免運費


-
海外
- 國際快遞:全球
-
港澳店取:


詳細資料
詳細資料
-
- 語言
- 中文繁體
- 裝訂
- 紙本平裝
-
- ISBN
- 9786266542010
- 分級
- 普通級
-
- 頁數
- 464
- 商品規格
- 23*17*2.27
-
- 出版地
- 台灣
- 適讀年齡
- 全齡適讀
-
- 注音
- 級別
訂購/退換貨須知
加入金石堂 LINE 官方帳號『完成綁定』,隨時掌握出貨動態:
提醒您!!
金石堂及銀行均不會請您操作ATM! 如接獲電話要求您前往ATM提款機,請不要聽從指示,以免受騙上當!
退換貨須知:
**提醒您,鑑賞期不等於試用期,退回商品須為全新狀態**
-
依據「消費者保護法」第19條及行政院消費者保護處公告之「通訊交易解除權合理例外情事適用準則」,以下商品購買後,除商品本身有瑕疵外,將不提供7天的猶豫期:
- 易於腐敗、保存期限較短或解約時即將逾期。(如:生鮮食品)
- 依消費者要求所為之客製化給付。(客製化商品)
- 報紙、期刊或雜誌。(含MOOK、外文雜誌)
- 經消費者拆封之影音商品或電腦軟體。
- 非以有形媒介提供之數位內容或一經提供即為完成之線上服務,經消費者事先同意始提供。(如:電子書、電子雜誌、下載版軟體、虛擬商品…等)
- 已拆封之個人衛生用品。(如:內衣褲、刮鬍刀、除毛刀…等)
- 若非上列種類商品,均享有到貨7天的猶豫期(含例假日)。
- 辦理退換貨時,商品(組合商品恕無法接受單獨退貨)必須是您收到商品時的原始狀態(包含商品本體、配件、贈品、保證書、所有附隨資料文件及原廠內外包裝…等),請勿直接使用原廠包裝寄送,或於原廠包裝上黏貼紙張或書寫文字。
- 退回商品若無法回復原狀,將請您負擔回復原狀所需費用,嚴重時將影響您的退貨權益。


商品評價
評價規範